Dos colegios pueden obtener promedios diferentes en Saber 11, pero detrás de cada promedio puede haber cantidades muy distintas de estudiantes. Un análisis de EduLogic sobre las aplicaciones de 2024 y 2025 examina qué tan comparable es realmente un resultado cuando cambia el tamaño de la cohorte que lo produce.
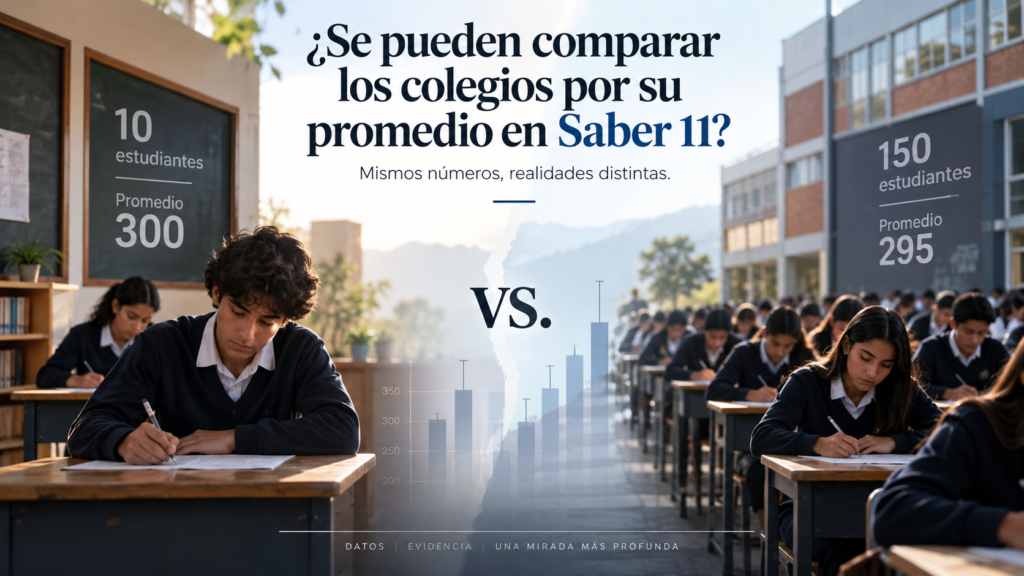
Imagine dos colegios. El primero presentó a Saber 11 a 10 estudiantes y obtuvo un promedio de 300 puntos. El segundo presentó a 150 estudiantes y obtuvo 295. Si la comparación se limita a esos dos números, no hay mucho que discutir: 300 es mayor que 295. Pero la pregunta cambia cuando se mira lo que hay detrás de cada cifra. El primer promedio depende de un grupo pequeño, en el que el resultado de unos pocos estudiantes puede modificar de manera importante el resultado final; el segundo proviene de una cohorte mucho más amplia, en la que esos mismos resultados individuales tienen un efecto menor. Los dos promedios pueden estar correctamente calculados, pero no necesariamente ofrecen el mismo nivel de precisión para establecer una diferencia entre las instituciones.
Esta es la pregunta que dio origen al análisis: ¿se pueden comparar los colegios por su promedio en Saber 11 cuando el número de estudiantes evaluados es tan diferente? Para examinarla, EduLogic trabajó con los resultados agregados del ICFES correspondientes exclusivamente a las cuatro aplicaciones de 2024 y 2025 —2024-1, 2024-2, 2025-1 y 2025-2— y estudió la relación entre el tamaño de las cohortes, la precisión de los promedios y la forma en que cambian los rankings cuando se introducen distintos criterios de tamaño.
Detrás de cada promedio hay una cantidad de estudiantes
El tamaño de la cohorte no es un detalle menor. En las cuatro aplicaciones analizadas, el 18,6 % de los registros institucionales correspondió a grupos de menos de 10 estudiantes evaluados; el 39,7 % tuvo menos de 20 y el 55 % menos de 30. Cuando el límite se amplía a 50 estudiantes, la proporción alcanza el 72,6 %. Esto significa que una parte considerable de los resultados institucionales procede de grupos relativamente pequeños, precisamente aquellos en los que un número reducido de estudiantes puede tener un efecto importante sobre el promedio.
La estadística permite medir qué implica esa diferencia. Al calcular intervalos de confianza del 95 % para los promedios de las áreas, aparece un patrón muy claro: a medida que aumenta el número de estudiantes, el intervalo se hace más estrecho y, por tanto, la estimación es más precisa. En Matemáticas, por ejemplo, entre las instituciones con 1 a 4 estudiantes la mediana del ancho del intervalo fue cercana a 40 puntos, mientras que entre aquellas con 100 a 199 estudiantes fue inferior a 4 puntos, considerando únicamente los casos en los que era posible calcularlo. El mismo comportamiento se observó en Lectura Crítica, Sociales y Ciudadanas, Ciencias Naturales e Inglés. La relación entre el tamaño de la cohorte y la amplitud del intervalo fue fuerte y negativa en las cinco áreas, con correlaciones de Spearman que oscilaron aproximadamente entre -0,83 y -0,90.
Lo que muestran estos resultados no es que los colegios con más estudiantes tengan un mejor desempeño. Muestran que sus promedios pueden estimarse con mayor precisión. Es una diferencia fundamental. El tamaño de una cohorte no convierte un resultado bajo en alto ni uno alto en bajo; lo que modifica es la cantidad de información disponible para interpretar con confianza ese resultado.
Cuando una diferencia se convierte en un puesto
La cuestión adquiere mayor importancia cuando los promedios dejan de ser simples indicadores y se utilizan para construir rankings. Una tabla que ordena colegios del primero al último no solo muestra resultados: implícitamente invita a interpretar que quien está arriba tiene un desempeño superior al que está abajo. Sin embargo, si dos promedios tienen diferentes niveles de incertidumbre, una diferencia numérica entre ellos no necesariamente constituye evidencia suficiente de una diferencia real entre las instituciones.
Los datos de 2025-2 ofrecen un ejemplo especialmente ilustrativo. En el ranking construido a partir del Puntaje Global calculado con los resultados de las cinco áreas, la primera posición correspondía a una institución con un solo estudiante evaluado y un resultado aproximado de 388 puntos. El cálculo del promedio no tiene por qué estar equivocado: con un estudiante, el promedio institucional es el resultado de ese estudiante. El problema aparece al intentar interpretar ese número como evidencia de que la institución supera a otra. Con una sola observación no es posible estimar una desviación estándar institucional ni construir un intervalo de confianza convencional, por lo que no podemos atribuirle el mismo nivel de certeza que a un promedio obtenido con una cohorte considerablemente mayor.
El ejercicio se vuelve todavía más revelador cuando se modifica el tamaño mínimo de la cohorte. Sin establecer ningún criterio, una institución con un solo estudiante puede ocupar el primer lugar; al exigir al menos 10 estudiantes, la composición de los primeros puestos cambia; con un mínimo de 30 vuelve a cambiar y con 50 aparece nuevamente una lista diferente. El objetivo de este ejercicio no es declarar que uno de esos rankings sea correcto y los demás incorrectos. Lo que muestra es que la posición relativa de una institución puede ser sensible al número de estudiantes que produjo su promedio.
El promedio no está mal; la interpretación puede ir demasiado lejos
Esta distinción permite evitar una conclusión equivocada: el problema no es que los promedios institucionales sean inútiles o que los resultados de los colegios no puedan compararse. El problema aparece cuando se interpreta una diferencia entre promedios como si, por el simple hecho de existir, demostrara una superioridad estadística. Un colegio puede obtener 320 puntos y otro 315, pero esos cinco puntos no tienen necesariamente la misma fuerza estadística si uno de los resultados proviene de una cohorte muy pequeña y el otro de una mucho mayor. Para determinar qué tan sólida es la diferencia se necesita mirar también la incertidumbre de cada estimación.
Esta preocupación no es exclusiva de Saber 11. Desde hace décadas, la literatura estadística sobre rankings educativos ha señalado que las posiciones de las instituciones deben interpretarse teniendo en cuenta la incertidumbre de sus estimaciones. Goldstein y Spiegelhalter mostraron en 1996 las limitaciones de las llamadas tablas de clasificación institucionales, mientras que trabajos posteriores de Goldstein y de Leckie y Goldstein profundizaron en el problema de utilizar estas posiciones para comparar escuelas o tomar decisiones. Investigaciones realizadas en otros sistemas educativos también han encontrado que las instituciones con cohortes pequeñas presentan estimaciones menos precisas y mayor incertidumbre. Aunque esos estudios no analizan específicamente Saber 11, respaldan el principio estadístico observado en los datos colombianos: el tamaño de la cohorte importa cuando se pretende interpretar y comparar promedios institucionales.
Comparar resultados no es medir toda la calidad de un colegio
Hay además una segunda precaución. Un resultado de Saber 11 describe el desempeño de los estudiantes evaluados en una prueba estandarizada, pero no constituye por sí solo una medida completa de la calidad educativa de una institución. El contexto de los estudiantes, las condiciones sociales, las características institucionales y las prácticas pedagógicas son factores que pueden intervenir en los resultados, y establecer su efecto requeriría otro tipo de investigación. Este análisis no busca determinar cuáles colegios ofrecen una educación de mayor calidad ni establecer una relación causal entre el tamaño de una institución y su desempeño.
La pregunta es más concreta: qué tan comparable es el promedio institucional cuando cambia el número de estudiantes que lo produce. Y en ese punto los resultados son consistentes. El promedio sigue siendo un dato válido, pero la precisión con la que puede interpretarse depende, entre otros factores, del tamaño de la cohorte.
Entonces, ¿se pueden comparar los colegios?
Sí, pero no basta con mirar cuál promedio es mayor. Una comparación rigurosa debería incorporar, junto al resultado, el número de estudiantes evaluados y alguna medida de la incertidumbre asociada a la estimación. Dependiendo del propósito, también puede ser razonable establecer criterios mínimos de tamaño de cohorte, siempre que estén estadísticamente justificados; los puntos de corte de 10, 20, 30 y 50 utilizados en este análisis son escenarios para observar cómo cambia un ranking, no una propuesta de tamaño mínimo universal.
También importa el contexto de la aplicación. Las pruebas de calendario A y B corresponden a poblaciones diferentes y no deberían mezclarse sin una justificación adecuada. En los datos analizados, por ejemplo, el Puntaje Global promedio ponderado calculado a partir de los resultados institucionales fue de aproximadamente 250 puntos en las aplicaciones de calendario A y de 318 en las de calendario B. Esa diferencia no permite afirmar que exista un efecto causal del calendario; muestra, más bien, por qué los resultados deben analizarse teniendo en cuenta el contexto de cada aplicación.
La conclusión, entonces, no es que los rankings deban desaparecer ni que un colegio con pocos estudiantes no pueda mostrar un resultado destacado. Es mucho más sencilla: un promedio es una medida, pero no todos los promedios ofrecen la misma precisión. Cuando se utilizan para ordenar instituciones o afirmar que una está por encima de otra, el número de estudiantes y la incertidumbre estadística deberían formar parte de la comparación.
La pregunta inicial tenía una respuesta aparentemente fácil: basta con mirar cuál número es más alto. Después de observar los datos, la respuesta es un poco más incómoda. Sí se pueden comparar los colegios por su promedio en Saber 11, pero el promedio bruto por sí solo no constituye evidencia suficiente para afirmar que una institución es estadísticamente superior a otra, especialmente cuando las cantidades de estudiantes evaluados son muy diferentes.
El promedio puede decir quién obtuvo el número más alto. La estadística permite saber qué tan sólida es la diferencia que estamos observando.
Y ahí está el punto que suele perderse cuando una tabla convierte resultados educativos en posiciones: el problema no está en calcular el promedio; está en creer que todos los promedios ofrecen el mismo nivel de certeza.
Los datos detrás del análisis
El estudio utilizó los resultados agregados del ICFES correspondientes a las aplicaciones 2024-1, 2024-2, 2025-1 y 2025-2. Los registros fueron consolidados por institución y se analizaron el número de estudiantes evaluados, los promedios y las desviaciones estándar reportadas para las cinco áreas de Saber 11.
Los intervalos de confianza se calcularon principalmente para las áreas individuales. El Puntaje Global empleado en los ejemplos de ranking fue calculado a partir de los promedios de las cinco áreas mediante la fórmula oficial del ICFES. No se presenta un intervalo exacto para ese Puntaje Global porque los datos agregados disponibles no contienen las covarianzas necesarias para calcular directamente la varianza del compuesto. En consecuencia, la evidencia principal sobre precisión procede de las áreas individuales y el Puntaje Global se utiliza para ilustrar los cambios en las posiciones de los rankings.
Las proporciones sobre tamaño de cohorte corresponden a registros u observaciones institucionales de las cuatro aplicaciones, no a un conteo de instituciones únicas. Asimismo, cuando una institución tiene un solo estudiante no es posible estimar una desviación estándar institucional convencional ni un intervalo de confianza basado en ella.
Fuentes principales
ICFES. Resultados agregados de Saber 11, aplicaciones 2024-1, 2024-2, 2025-1 y 2025-2.
Goldstein, H. & Spiegelhalter, D. J. (1996). League Tables and Their Limitations: Statistical Issues in Comparisons of Institutional Performance. Journal of the Royal Statistical Society: Series A.
Leckie, G. & Goldstein, H. (2009). The Limitations of Using School League Tables to Inform School Choice. Journal of the Royal Statistical Society: Series A.
Goldstein, H. (2014). Using League Table Rankings in Public Policy Formation: Statistical Issues. Annual Review of Statistics and Its Application.
Dragoset, L. et al. (2019/2020). Measuring School Performance for Early Elementary Grades in Maryland. Regional Educational Laboratory.
Jeon, M., Lee, J., Hwang, S. & Kang, S. (2009). Estimating reliability of school-level scores using multilevel and generalizability theory models. Asia Pacific Education Review.
Investigación y análisis: EduLogic.